點解存在
唔好每個應用都各自裝一套模型。
私有 AI 要兩層:應用邏輯,同模型推理。砌埋一齊就會將 GPU 鎖死喺一個產品,系統營運都會倍增。
冇共用控制層
算力各自為政。每個產品都要重新搞一套。好難跨產品共用。
應該點做
呼叫 AI 微服務
共用推理 · 多個應用
模型變成好多產品都可以呼叫嘅 AI 微服務。Data Nexus 喺你自己嘅環境管治同交付呢層底層。
實際得益
點解需要 Data Nexus。
推理共用咗之後,你仍然需要一個自己託管嘅控制層去登記、保安同交付。呢個就係 Data Nexus 嘅工作。
01
GPU 服務成個環境
推理以共用服務行 — 算力匯喺一齊,唔困喺單一應用。
02
應用守住邏輯
產品呼叫呢層底層。唔使每個都自己出、託管同營運一套模型。
03
一個受管入口
金鑰、權限同審計,同時擋喺私有 GPU 同已批准雲 API 前面。
04
一個控制層去營運
由單一控制層登記服務、監察狀況,再喺成個環境入面路由流量。
點樣運作
一層。兩份工。
管邊個可以用推理,再喺你託管嘅基礎設施上面,送到 GPU 同已批准雲。深層架構留喺私人檢視。
呢層點樣運作
自己託管 · 喺你環境
應用同合作夥伴由一個受管入口入嚟。Data Nexus 決定邊個可以用,再喺你託管嘅環境交付推理。
受管入口
每個 AI 產品同一個門應用、合作夥伴同營運人員用已核實嘅權限入嚟 — 唔使每個團隊自己砌一道前門。
↓ 兩份工,一個平台
營運同管治
控制
- 喺一個位睇晒所有推理服務
- 決定邊個可以呼叫咩
- 存取同變更都有清楚紀錄
路由同服務
交付
- 將工作送到啱嘅算力
- 私有 GPU 同已批准雲行同一條路徑
- 應用串流或者即時傾偈都保持快
↓ 去到你掌控嘅算力
你嘅環境
推理實際跑嘅地方你嘅 GPU
你自己行嘅本地模型
你環境入面嘅節點
健康同本地控制
已批准雲
適合用混合嘅時候
由呼叫到答
01
接駁
你嘅應用到達一個私有入口。
02
管治
先檢查權限同政策。
03
交付
工作去到啱嘅 GPU 或者雲路徑。
04
證明
營運同合規睇到發生過咩。
喺呢層底層上面
第一批應用。
部署
永遠由客戶託管。
喺你本地伺服器或者私有雲上面行。
單一環境
平台同推理喺同一個環境。
分散式叢集
中央樞紐,GPU worker 喺邊緣。
混合 AI
本地模型 + 受管雲連接器。
控制台入面
一眼睇晒控制台。
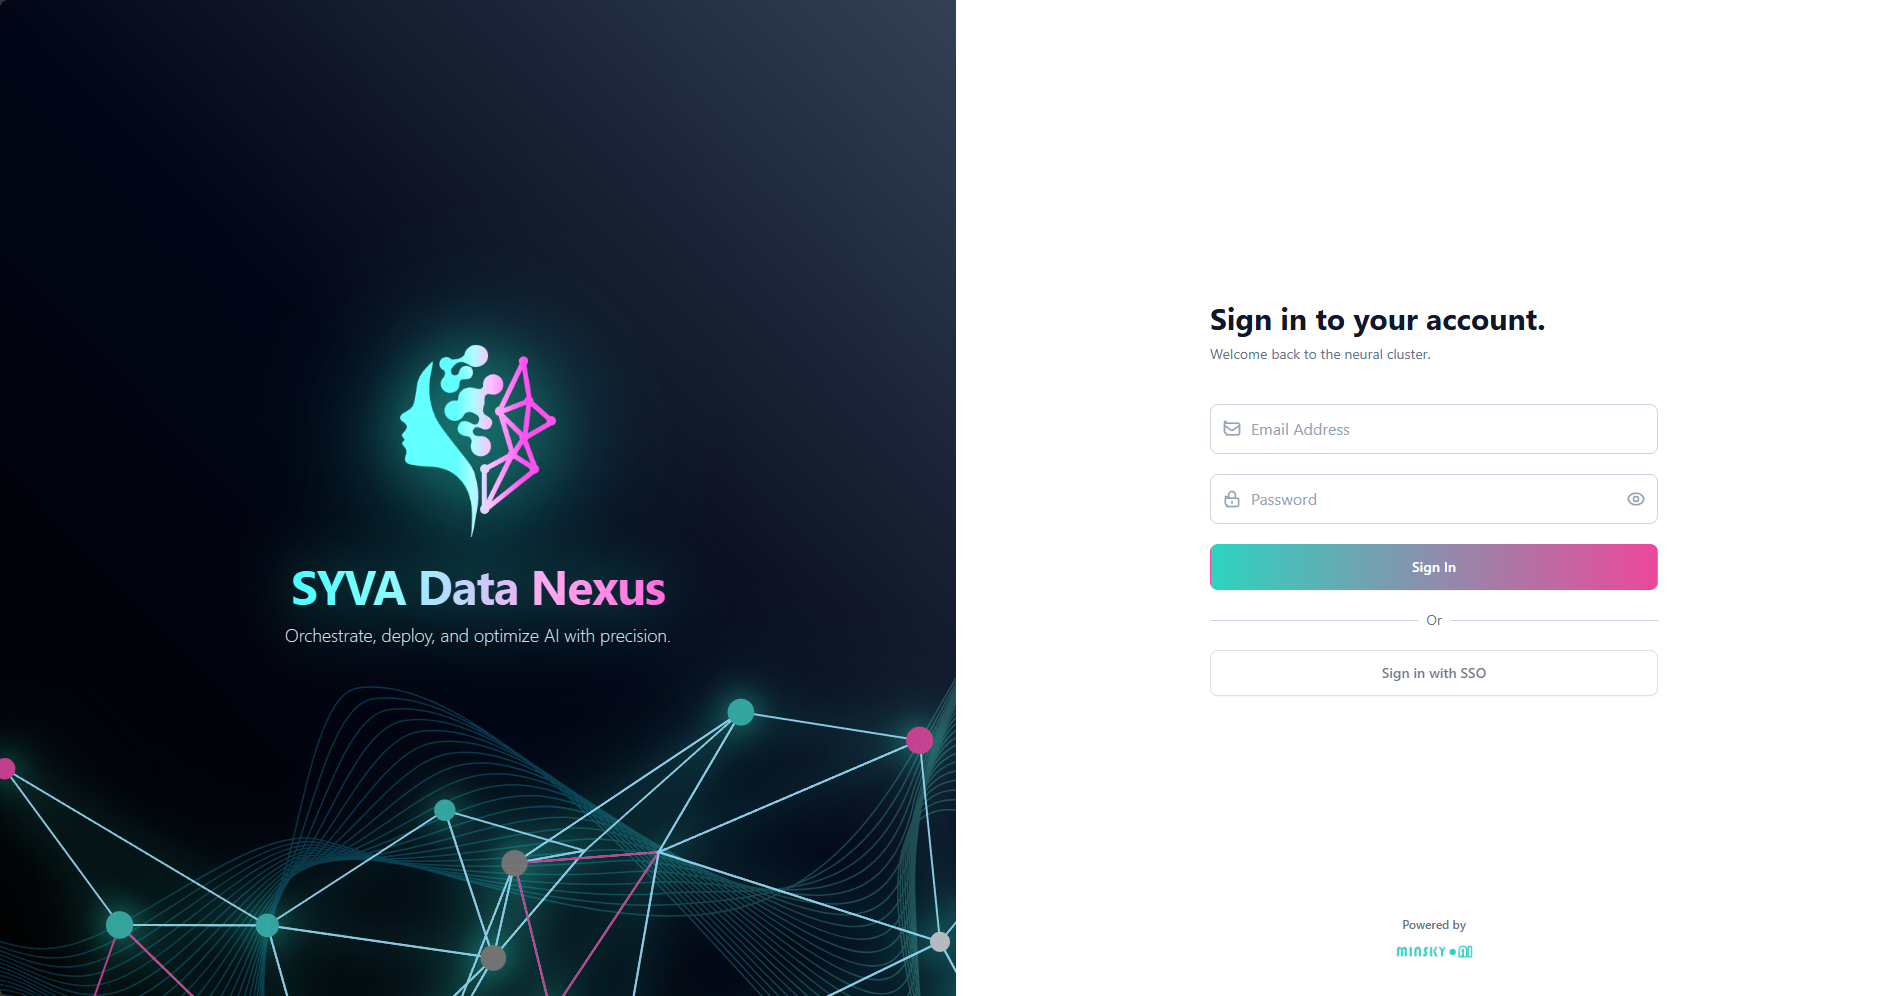
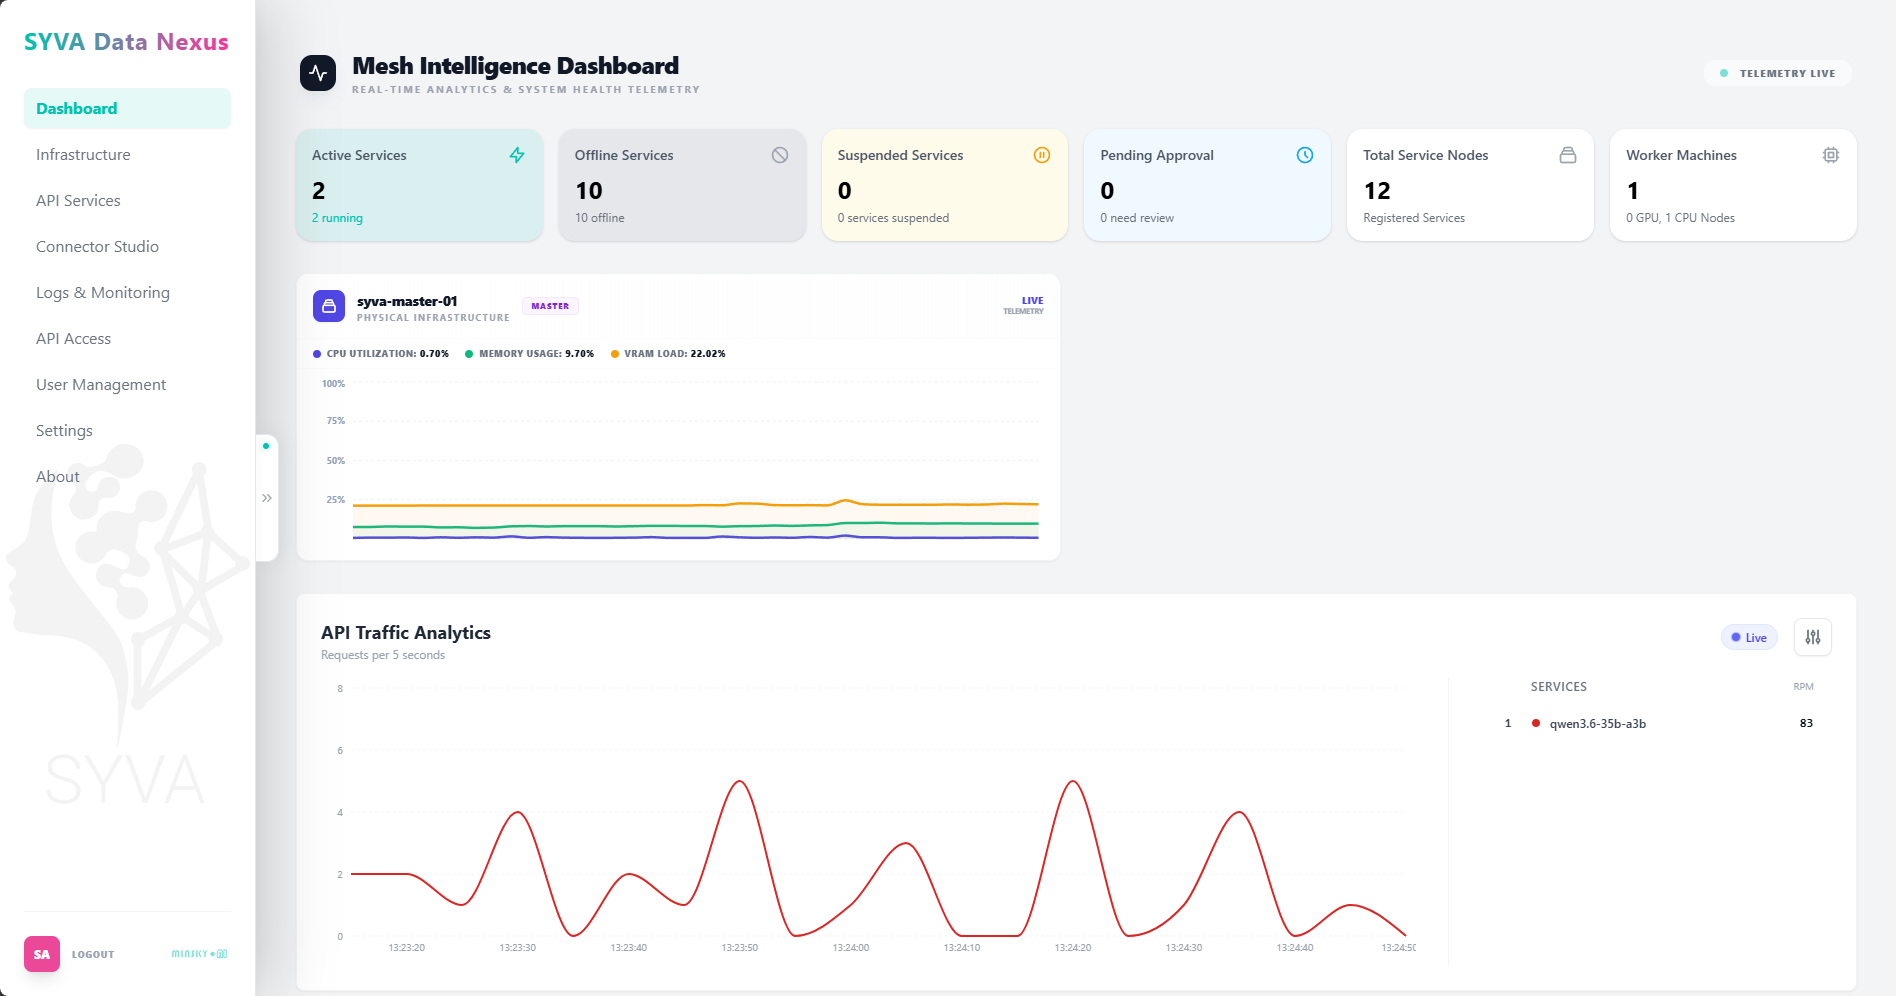
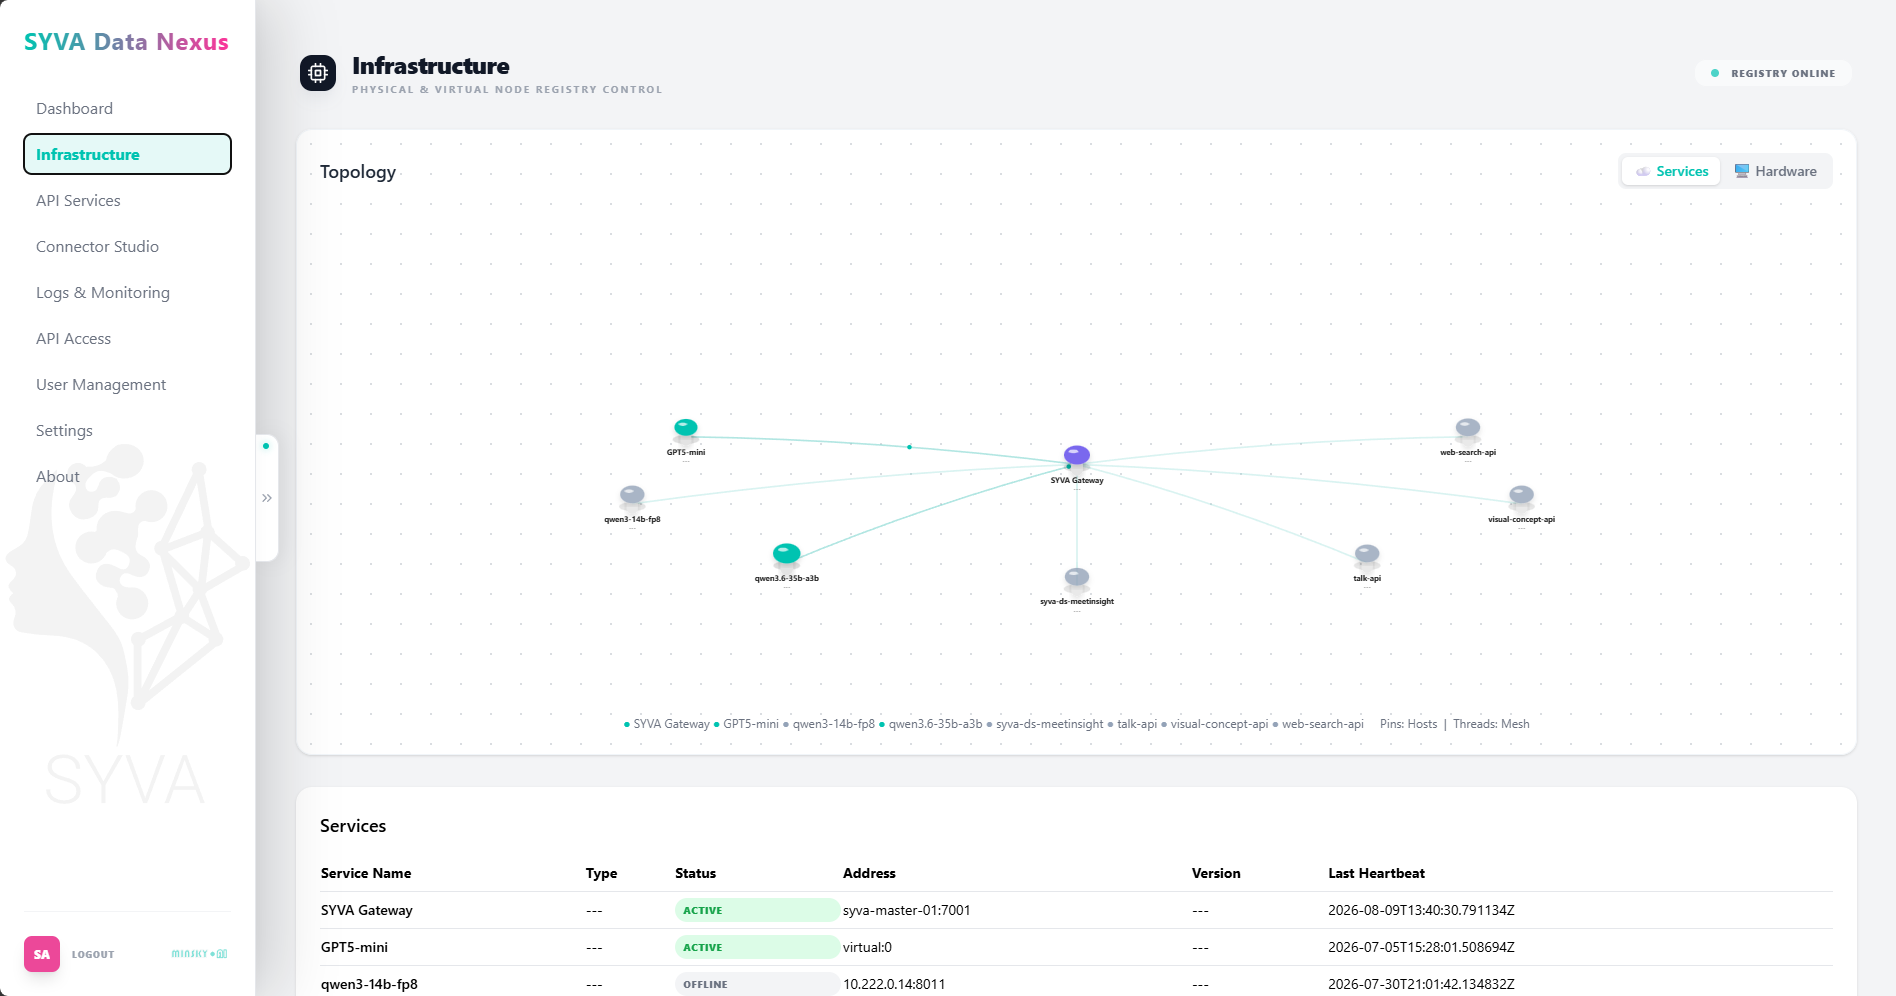
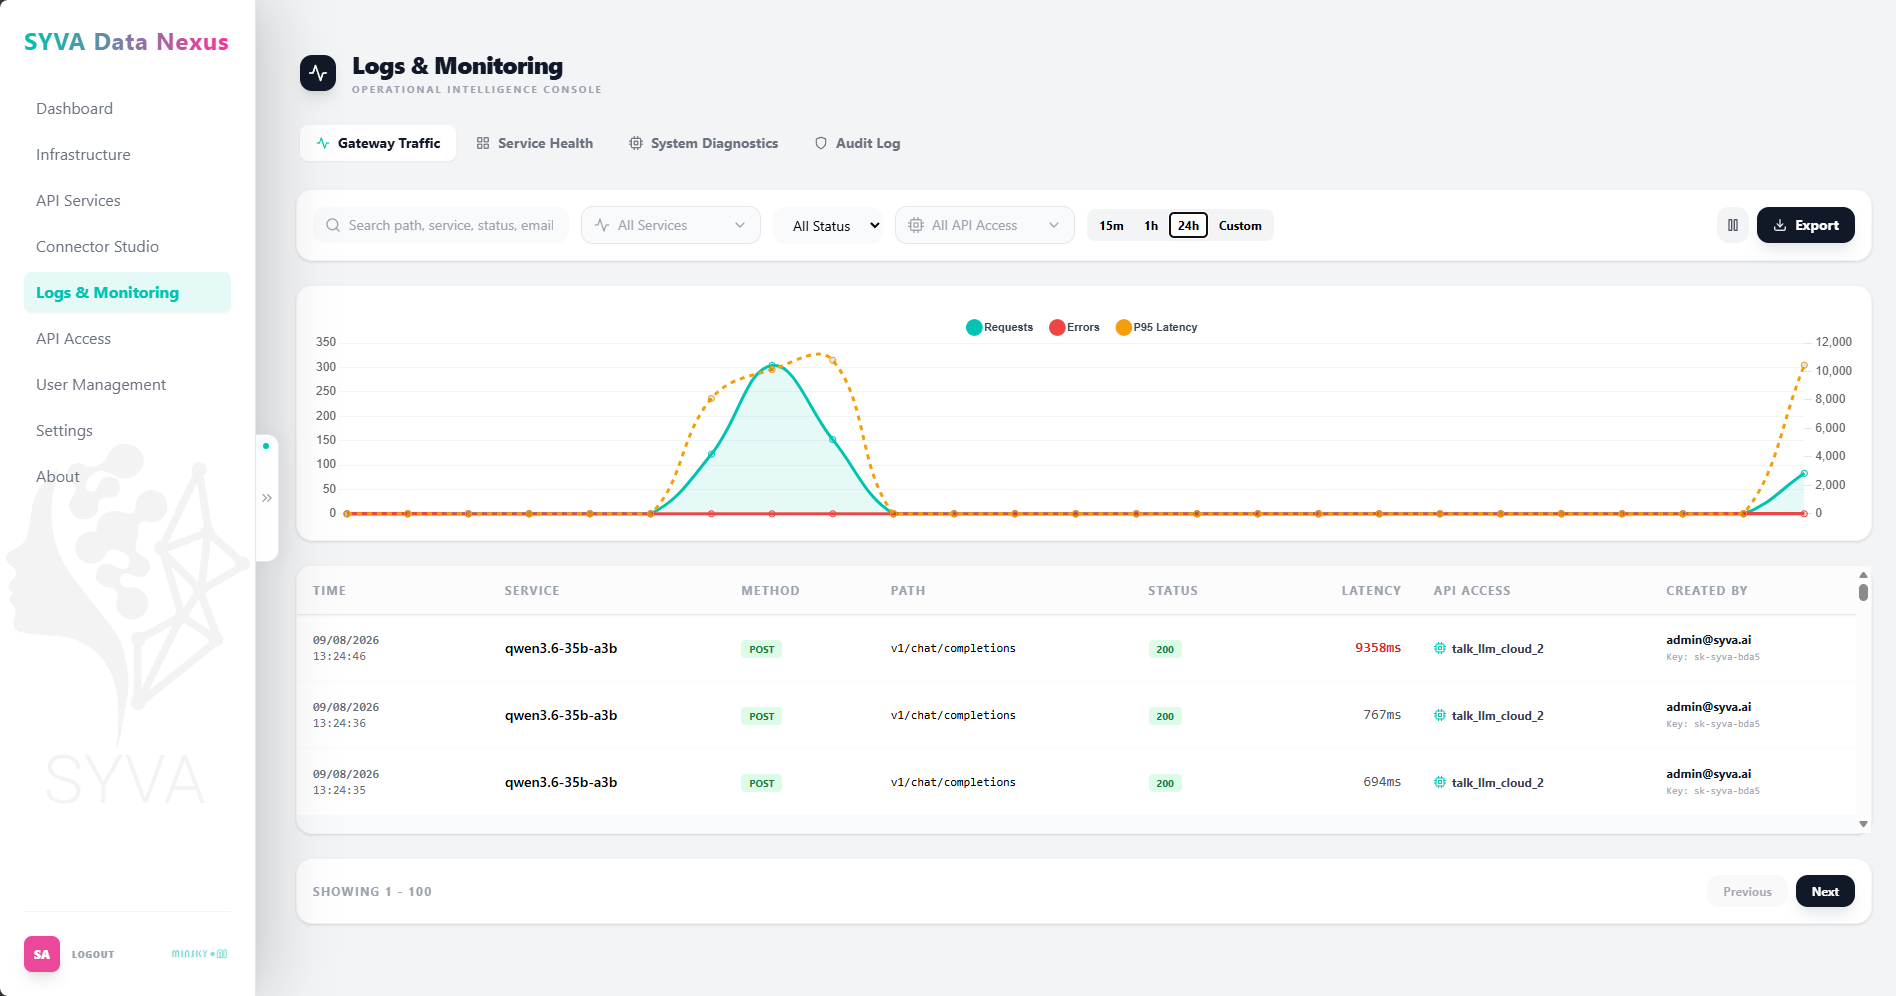
登入、mesh 健康、拓撲同即時 gateway 流量 — 夠你見到呢層控制層,唔係完整產品導覽。
01 / 04
登入
受管登入私有控制層。